A Meta-Robots-Tag ist eine HTML-Direktive auf Seitenebene, die steuert, wie Crawler das Crawl-, Indexierungs- und Snippet-Verhalten handhaben. Der Standard ist index, follow. Ich habe eine einzelne noindex Zeile gesehen, die den Traffic über Nacht ausgelöscht hat, normalerweise auf einer Seite, von der jemand annahm, sie sei „sicher“, weil sie nur im <head>.
Das ist der Teil, den die Leute übersehen, wenn sie Robots-Direktiven wie eine Checkbox behandeln. In der Praxis ist der Tag eine Debugging-Oberfläche, und wenn ich einen plötzlichen Rückgang nachverfolge, beginne ich damit, die gerenderte Quelle zu überprüfen, bevor ich Inhalte, Links oder „den Algorithmus“ beschuldige. Wenn Sie sich in derselben Situation befinden, finden Sie heraus, warum Ihr Traffic eingebrochen ist ist ein nützlicher Begleiter, während Sie die URL selbst inspizieren, und ich kombiniere das normalerweise mit einem schnellen Blick auf die URL-bezogene Historie in SemDashs Traffic-Schätzungstools.
Inhaltsverzeichnis
- Wenn ein Meta-Robots-Tag Ihren Traffic leise tötet
- Die vier Direktivenfamilien und was jede einzelne bewirkt
- Meta Robots Tag vs. X-Robots-Tag Header
- Drei echte Vorlagen, die ich auf Produktionsseiten verwende
- Fünf Direktiven, die ich jede Woche falsch verwendet sehe
- Die Meta Robots Audit-Checkliste, die ich jedes Quartal durchführe
- Behebung der Probleme und Validierung des Ergebnisses
Wenn ein Meta-Robots-Tag Ihren Traffic leise tötet
Ich hatte denselben Anruf öfter, als ich zählen kann. Eine Seite, die früher gut gerankt hat, verschwindet, der Kunde schwört, dass sich nichts geändert hat, und dann zeigt der Crawl-Export eine einzige Zeile im Head, <meta name="robots" content="noindex">. Diese eine Zeile reicht aus, um eine URL aus den Suchergebnissen zu entfernen, da Googles Standard immer noch index, follow, daher ist das Tag nur wichtig, wenn Sie ein anderes Verhalten wünschen. Die eigene Dokumentation von Google stellt diesen seitenbezogenen Rahmen in den Vordergrund, einschließlich der neueren Betonung der seitenbezogenen Steuerung in seinem Robots-Update für 2025, weshalb das Tag in der modernen SEO-Governance immer noch wichtig ist. Googles Meta-Robots-Dokumentation
Warum ich es wie einen Debugging-Hebel behandle
Der Fehler liegt nicht in der Verwendung des Tags. Der Fehler liegt darin, es wie eine Vorlageneinstellung zu behandeln, die man vergessen kann. Sobald ein Team noindex, nofollow, oder Snippet-Beschränkungen hinzufügt, kann diese Anweisung ändern, ob eine URL in der Suche erscheint, ob Links auf dieser Seite verfolgt werden und ob Snippets oder gecachte Inhalte überhaupt angezeigt werden. Deshalb betrachte ich das Tag als Steuerungsoberfläche für die Architektur, nicht als kosmetisches SEO-Tuning.
Praktische Regel: wenn eine URL an Sichtbarkeit verloren hat und sich der Inhalt nicht wesentlich geändert hat, überprüfen Sie zuerst den Head. Ich habe falsch angewendete Robots-Anweisungen auf Staging-Vorlagen, duplizierte Seitenvorlagen und sogar Produktdetailseiten gefunden, die versehentlich eine Blog-Regel geerbt haben.
Die vier Direktivenfamilien sind wichtig, weil sie unterschiedlich versagen. Indexierungsdirektiven entscheiden, ob eine Seite überhaupt erscheinen kann. Crawling- und Link-Direktiven formen, was verfolgt wird. Snippet-Direktiven ändern, was Google in den SERPs anzeigen möchte. Und textuelle Steuerelemente wie data-nosnippet ermöglichen es dir, Teile einer Seite zu verbergen, ohne die gesamte URL abzudecken.
Deshalb ist ein Debugging-Workflow besser als eine auswendig gelernte Checkliste. Ich möchte wissen, was der Crawler gesehen hat, was die SERP angezeigt hat und welches Template das Tag ausgegeben hat. Wenn diese drei nicht übereinstimmen, ist das Robots-Tag normalerweise der schnellste Weg, die Lücke zu erklären.
Die vier Direktivenfamilien und was jede einzelne bewirkt
Indexierungssteuerung
Das sind die Direktiven, die ich zuerst überprüfe, wenn eine Seite aus dem Index verschwindet. index erlaubt die Einbeziehung, noindex schließt die Seite aus, und none ist eine Kurzform für noindex, nofollow. Google sagt auch, dass der Standard bereits index, followist, daher ist explizites index, follow normalerweise überflüssig, es sei denn, du dokumentierst die Absicht in einem Template.
Ein sauberes Beispiel sieht so aus:
<meta name="robots" content="noindex,follow">
Das weist Crawler an, die Seite nicht zu indexieren, aber sie trotzdem den Links darauf folgen zu lassen. Ich verwende das für Seiten, die entdeckt, aber nicht eingestuft werden sollen, wie z. B. dünne Hilfsseiten oder bestimmte Filter. Die Fehlfunktion ist im Nachhinein offensichtlich, aber nicht im Moment der Bereitstellung. Jemand denkt none bedeutet „keine spezielle Behandlung“ und die Seite verschwindet.
Crawling- und Link-Steuerung
follow und nofollow bestimmen, ob der Crawler Links auf der Seite durchlaufen soll. Auf einer Seite, die aus dem Index herausgehalten werden muss, aber dennoch die Entdeckung unterstützen soll, bevorzuge ich normalerweise noindex, follow über ein pauschales none weil Letzteres auch das Folgen von Links blockiert.
<meta name="robots" content="noindex,nofollow">
Diese Version entfernt die Seite und unterdrückt das Folgen von Links. Es ist nützlich, wenn die Seite selbst totes Gewicht ist, kann aber zu aggressiv sein, wenn die Seite immer noch wertvolle interne Pfade enthält. Ich habe Teams gesehen, die Crawling-Pfade durch die Verwendung von nofollow auf Seiten in der Nähe wichtiger Kategorie-Hubs unterbrochen haben.
Snippet- und Quellcode-Steuerelemente
Google unterstützt einen separaten Satz von Snippet-Direktiven, einschließlich nosnippet, max-snippet, max-image-preview, max-video-preview, und unavailable_after. nosnippet ist das stumpfe Instrument. max-snippet:50 ist eine Kappe. max-image-preview:large und seine Geschwister steuern die Vorschau-Behandlung. unavailable_after ist ein zeitgesteuertes Entfernungssignal.
data-nosnippet funktioniert anders, da es auf Seitenelemente und nicht auf die gesamte URL angewendet wird. Das ist nützlich, wenn nur ein Teil einer Seite aus Snippets herausgehalten werden soll. Ich habe es auf Seiten verwendet, auf denen ein Absatz sensibel war, der Rest des Inhalts aber vollständig indexierbar bleiben musste.
Praktische Regel: Verwende die engste Direktive, die das eigentliche Problem löst. Wenn du nur ein Fragment ausblenden musst, setze nicht die gesamte URL auf noindex.
| Direktiven-Familie | Beispielwerte | Was es steuert |
|---|---|---|
| Indexierung | index, noindex, none |
Ob die URL in der Suche erscheinen kann |
| Crawling und Links | follow, nofollow |
Ob Links auf der Seite verfolgt werden |
| Snippet | nosnippet, max-snippet:50, max-image-preview:large, unavailable_after |
Was in den Suchergebnissen angezeigt wird und wie lange |
| Text-Level-Quellenkontrolle | data-nosnippet |
Bestimmte Seitenelemente, die nicht in Snippets verwendet werden können |
Meta Robots Tag vs. X-Robots-Tag Header
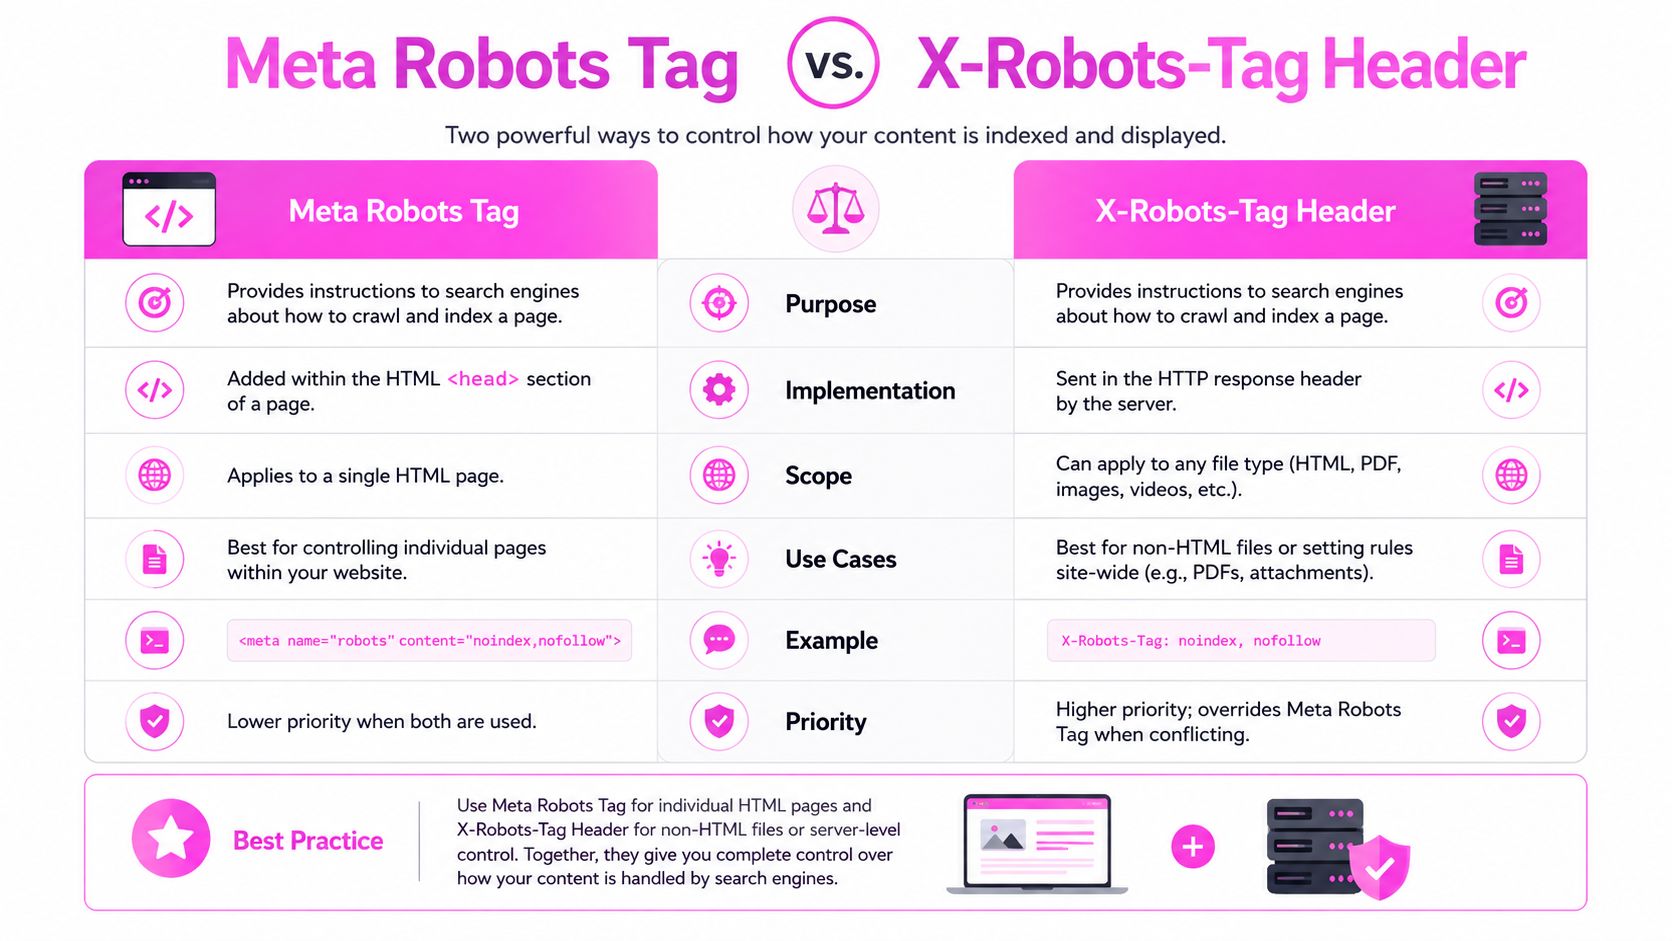
Ein Meta-Robots-Tag auf der Seite selbst ist der schnellste Weg, um normale HTML-URLs zu steuern. Das X-Robots-Tag Der Header löst die Fälle, in denen kein HTML-Head zum Bearbeiten vorhanden ist, sodass er für PDFs, Bilder und andere Assets geeignet ist, die außerhalb des Dokuments liegen. Die Dokumentation von Google trennt diese Verwendungen klar und zeigt auch, dass seitenbezogene Anweisungen in einem HTTP-Header übermittelt werden können, während textbezogene Steuerungen innerhalb des Seitenelements verbleiben. Googles Dokumentation zu speziellen Tags
Wo jeder seinen Platz hat
Ich behandle das Tag als eine Template-Entscheidung und den Header als eine Delivery-Layer-Entscheidung. In Shopify, WordPress oder jeder serverseitig gerenderten App ist das Meta-Tag normalerweise der sauberste Weg für HTML. Für eine PDF verschwende ich keine Zeit damit, zu versuchen, einen Head in die Datei zu zwingen. Ich setze den Header und mache weiter.
Diese Trennung ist noch wichtiger, wenn beide Anweisungen dieselbe URL treffen. Google wendet die strengere Regel an, sodass eine Seite mit einer Anweisung, die besagt index und eine andere, die besagt noindex wird der restriktiven Version folgen. Gemischte Bereitstellung ist, wo viele Indexierungsfehler auftreten, da die Seite im CMS gut aussieht, während der Crawler eine andere Anweisung vom Server oder CDN liest.
Was ich zuerst prüfe
Ich prüfe zuerst drei Dinge.
- Lieferort, ob die Anweisung im HTML oder im Header steht.
- Asset-Typ, ob die URL eine normale Seite oder eine Nicht-HTML-Datei ist.
- Kollisionsrisiko, ob eine CMS-Vorlage, eine CDN-Regel oder eine Serverkonfiguration bereits etwas Strengeres sendet.
Der größte operative Fehler ist die Annahme, dass das Meta-Tag und der Header austauschbar sind. Sie lösen unterschiedliche Implementierungsprobleme, und wenn beide auf derselben URL vorhanden sind, verhandelt der Crawler nicht. Er wählt den strengeren Weg.
Bei größeren Audits ordne ich diese Anweisungen den Crawling-Daten auf URL-Ebene zu, vergleiche dann die Live-Ausgabe mit dem historischen SERP-Verhalten mithilfe von SemDash und Tools wie Wispra's SEO-Crawler-Leitfaden. Dort zeigt sich normalerweise der stille Traffic-Verlust, eine parametrisierte URL verschwindet, eine PDF-Datei verschwindet aus der Indexabdeckung oder eine Vorlagenänderung sendet noindex zu Seiten, die sichtbar bleiben sollten.
Drei echte Vorlagen, die ich auf Produktionsseiten verwende
Ich habe immer wieder die gleichen drei Muster verwendet, weil sie echte Indexierungsprobleme lösen, ohne zu überkorrigieren. Sie sind oberflächlich einfach, aber der Unterschied zwischen einer sicheren Vorlage und einer fehlerhaften liegt normalerweise in einem Attribut.
Facettenreiche Navigation, die crawlbar bleiben sollte
Für Filter und facettenreiche URLs beginne ich normalerweise mit:
<meta name="robots" content="noindex,follow">
Das hält die Seite aus dem Index, während interne Links auffindbar bleiben. Es ist gut geeignet, wenn die Seite als Crawling-Pfad nützlich ist, aber nicht als Ranking-Ziel. Das Audit-Signal ist normalerweise ein unübersichtlicher URL-Cluster in der SERP-Historie, bei dem die gleiche Absicht zwischen parametrisierten URLs hin und her springt und eine davon nach einer Vorlagenänderung plötzlich herausfällt.
Dünne Tag-Seiten, die von einer Blog-Plattform generiert wurden
Wenn ein Blogsystem Dutzende von minderwertigen Tag-Seiten erstellt, verwende ich oft:
<meta name="robots" content="noindex,follow">
Der Grund ist einfach. Ich möchte, dass Suchmaschinen den Artikelgraphen weiterhin erreichen, aber ich möchte nicht, dass dünne Archive mit den eigentlichen Inhalten konkurrieren. Dies ergibt sich normalerweise nach einer Überprüfung der URL-zu-URL-Zuordnung, die zeigt, dass das Tag-Archiv indiziert wird, während der zugrunde liegende Artikel die Arbeit leistet.
Gated- oder Login-erforderliche Inhalte
Für gesperrte Inhalte kombiniere ich oft die Entfernungskontrolle mit der Snippet-Unterdrückung:
<meta name="robots" content="noindex,nosnippet">
Das gibt mir eine Seite, die nicht im Index erscheint und keine Vorschau preisgibt. Das ist nützlich, wenn der Inhalt bestehende Benutzer unterstützen soll und keinen öffentlichen Suchverkehr anziehen soll. Der Auslöser ist normalerweise eine SERP-Verlauf-Anomalie, bei der die Seite für Markentermine rankt, obwohl sie eindeutig nicht für die Öffentlichkeit bestimmt ist.
Wenn Sie einen breiteren Überblick darüber wünschen, wie sich Crawler über Vorlagen hinweg verhalten, Wispra's SEO-Crawler-Leitfaden ist eine praktische Referenz, insbesondere wenn Sie prüfen, ob das Problem im Rendering, in der Erkennung oder in der Handhabung von Direktiven liegt.
Ich habe festgestellt, dass CMS-Notizen genauso wichtig sind wie der Tag selbst. Wenn die Vorlagenvariable in einer Theme-Einstellung oder Routenkonfiguration versteckt ist, kann der nächste Bereinigungslauf Ihre Korrektur unbemerkt rückgängig machen.
Video-Walkthroughs helfen, wenn Sie dieselben Fehler über mehrere Vorlagen hinweg verfolgen.
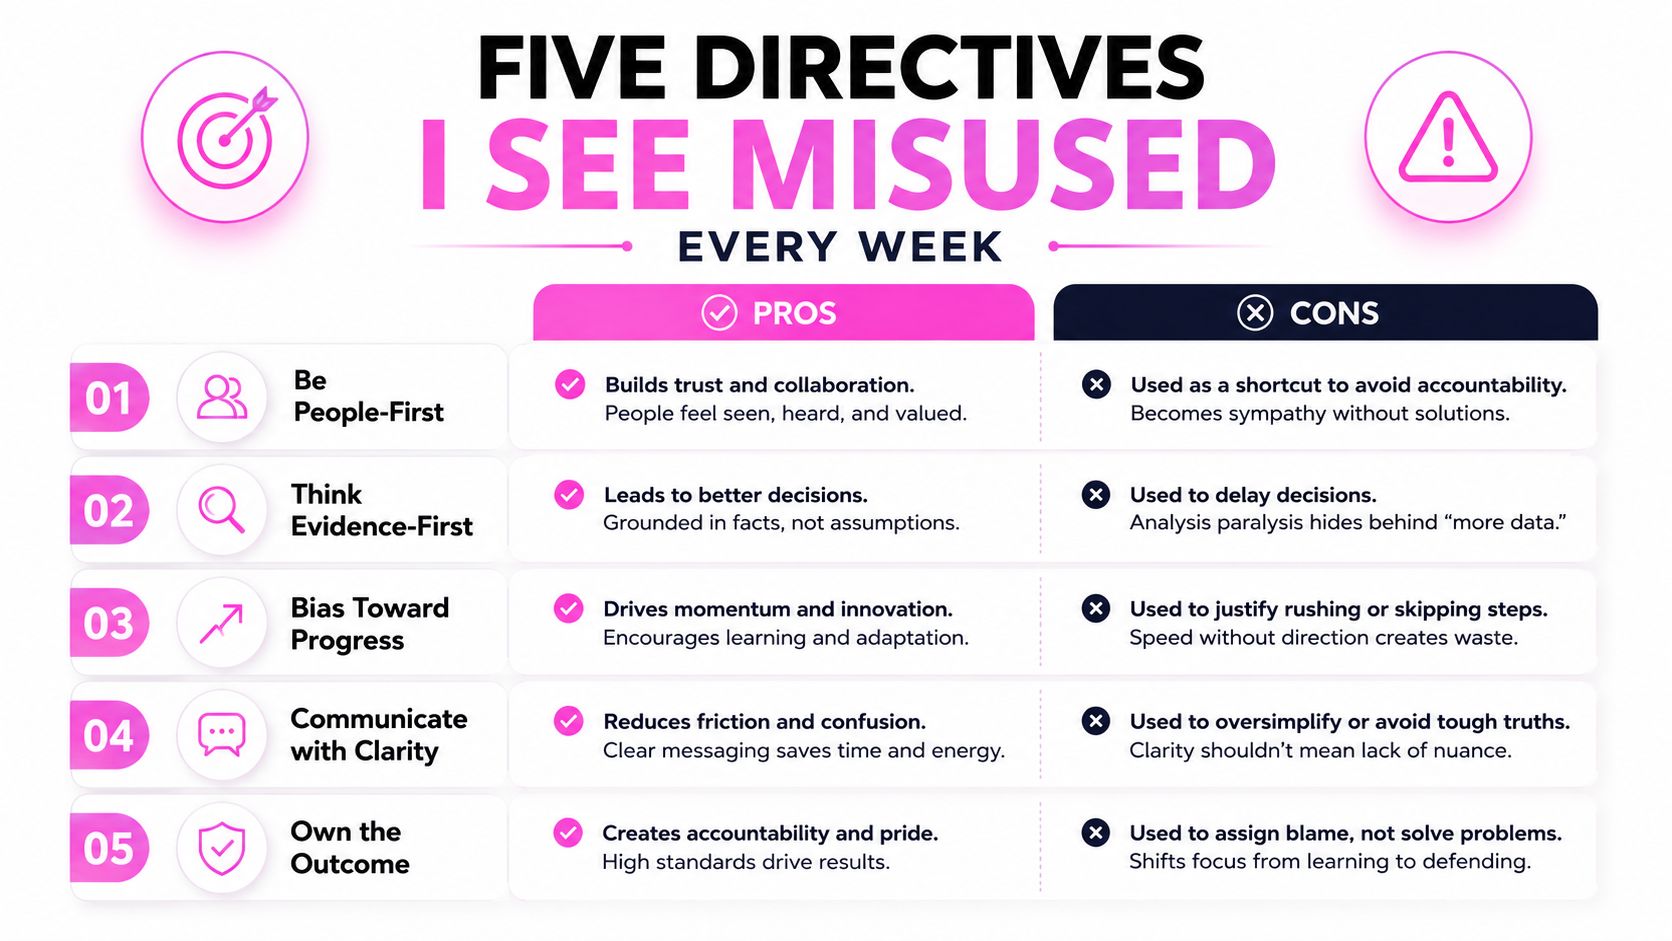
Fünf Direktiven, die ich jede Woche falsch verwendet sehe
Die häufigsten Robots-Fehler sind nicht dramatisch. Es sind kleine Diskrepanzen zwischen Absicht und Syntax, und sie äußern sich als stille Indexierungs-Eigenheiten, die wie ein Ranking-Problem aussehen, bis Sie die Quelle überprüfen.
Der Standard wird ohne Grund überschrieben
Ich sehe immer noch Vorlagen, die explizit hinzufügen index, follow überall. Das ist nicht schädlich, aber es überlädt den Header und erschwert Audits. Da Googles Standard bereits index, follow, lösen diese Zeilen selten etwas.
Eine bessere Version ist oft gar kein Meta-Robots-Tag. Wenn die Seite indexierbar sein soll, ist Stille sauberer als Zeremonie.
Der Kurzbefehl, den Leute falsch lesen
none ist das, was Teams am meisten stolpern lässt. Es bedeutet nicht „keine spezielle Behandlung“. Es bedeutet noindex, nofollow. Ich habe beobachtet, wie ein ganzes Archiv verschwand, weil jemand annahm none sei ein neutraler Platzhalter.
Der Konflikt, der auf die falsche Weise gewinnt
Ein generischer robots Tag und ein Crawler-spezifischer googlebot Tag kann gestapelt werden, und Google wird das restriktivere Ergebnis verwenden. Das ist nützlich, wenn Sie eine Google-spezifische Ausnahme wünschen, aber gefährlich, wenn das Team vergisst, dass die allgemeine Regel noch gilt.
Ein fehlerhaftes Muster sieht so aus:
<meta name="robots" content="index">
<meta name="googlebot" content="noindex">
Google liest das als noindex. Wenn der Websitebesitzer erwartet hat, dass die allgemeine Regel gewinnt, ist die Überraschung normalerweise ein Traffic-Einbruch und viel Verwirrung.
Die Snippet-Steuerung, die die Seite nicht ausblendet
max-snippet:0 wird oft wie ein Versteckschalter verwendet. Das ist es nicht. Wenn das Ziel ist, die Seitenvorschau vollständig zu entfernen, nosnippet ist die direkte Direktive. Ich habe Teams gesehen, die max-snippet:0 verwendet haben und sich dann wunderten, warum das Ergebnis immer noch anders als ein vollständig unterdrückter Snippet war.
Die paginierte Seite, die überoptimiert wird
Das Noindexing von paginierten URLs ist eine häufige Überreaktion. Es kann nützliche Entdeckungspfade entfernen und die gesamte Serie schwieriger über den Crawl-Fluss zugänglich machen. Ich habe gesehen, wie es die Entdeckung auf großen Archivsystemen unterbrochen hat, wo die paginierte Ebene der einzige zuverlässige Pfad zu tieferen Inhalten war.
Regel, die ich verwende: Wenn eine Direktive die Sichtbarkeit unterdrücken soll, stelle sicher, dass sie tatsächlich die Ebene unterdrückt, die dir wichtig ist. Snippet-Steuerung ist keine Index-Steuerung, und Index-Steuerung ist kein Crawl-Pfad-Design.
Die Meta Robots Audit-Checkliste, die ich jedes Quartal durchführe
Der erste Durchlauf ist immer mechanisch. Ich exportiere jede crawl-bare URL und filtere dann nach Seiten, die überhaupt einen Meta-Robots-Tag enthalten, da der Standardzustand normalerweise kein Tag ist. Von dort vergleiche ich die Direktivenliste mit dem, was die SERP-Historie und die URL-zu-Mapping-Daten über die Zeit sagen, da dort stille Fehler zuerst auftreten. Die Markdown-API wird nützlich für Teams, die eine saubere HTML-zu-Text-Extraktion während Massenprüfungen benötigen, insbesondere wenn Quellseiten unordentlich oder stark vorlagenbasiert sind.
Was ich in welcher Reihenfolge prüfe
- Zuerst Crawl-Export. Ich markiere jede URL mit einer beliebigen Robots-Direktive und trenne HTML-Tags von Headern.
- Danach SERP-Historie. Ich vergleiche die Absicht der Direktive mit den Sichtbarkeitssignalen der letzten 12 Monate, um Seiten zu finden, die nicht zu ihrem aktuellen Status passen.
- Kollisionsprüfung. Ich prüfe auf widersprüchliche Meta-Tags und X-Robots-Tag-Header auf derselben URL.
- Crawler-spezifische Überschreibungen. Ich überprüfe, ob
googlebotRegeln die generischerobotsRegel nicht überschreiben. - Signal-Querverweis. Ich überprüfe die organische Traffic-Bewegung, verweisende Domains und AI Overview-Zitate, um Seiten zu identifizieren, die zu stark eingeschränkt sind.
Was die Diskrepanz normalerweise bedeutet
Wenn eine Seite markiert ist noindex aber immer noch rankt, finde ich normalerweise einen veralteten Cache, ein Rendering-Problem oder einen Header- und Head-Konflikt. Wenn eine Seite keine Direktive hat und plötzlich verschwunden ist, suche ich zuerst nach einem Problem mit der Vorlagenvererbung. Wenn die Seite wichtig ist und die Zuordnung ohne Content-Release geändert wurde, ist das ein starkes Zeichen dafür, dass die Robots-Regel irgendwo hinzugefügt wurde, das für das Content-Team nicht sichtbar ist.
Ich behalte auch Seiten-Gruppen im Auge, die für die Entdeckung offen geblieben sein sollten, aber während eines Cleanup-Sprints gestrafft wurden. Das sind diejenigen, die die interne Reichweite verlieren, während alle die „kontrolliertere“ Vorlage feiern.
SemDash's Workflow zur Content-Optimierung ist nützlich, wenn ich Roboter-Ergebnisse mit der allgemeinen Seitenleistung verknüpfen muss, da ein Direktiven-Bug selten auf eine URL beschränkt bleibt.
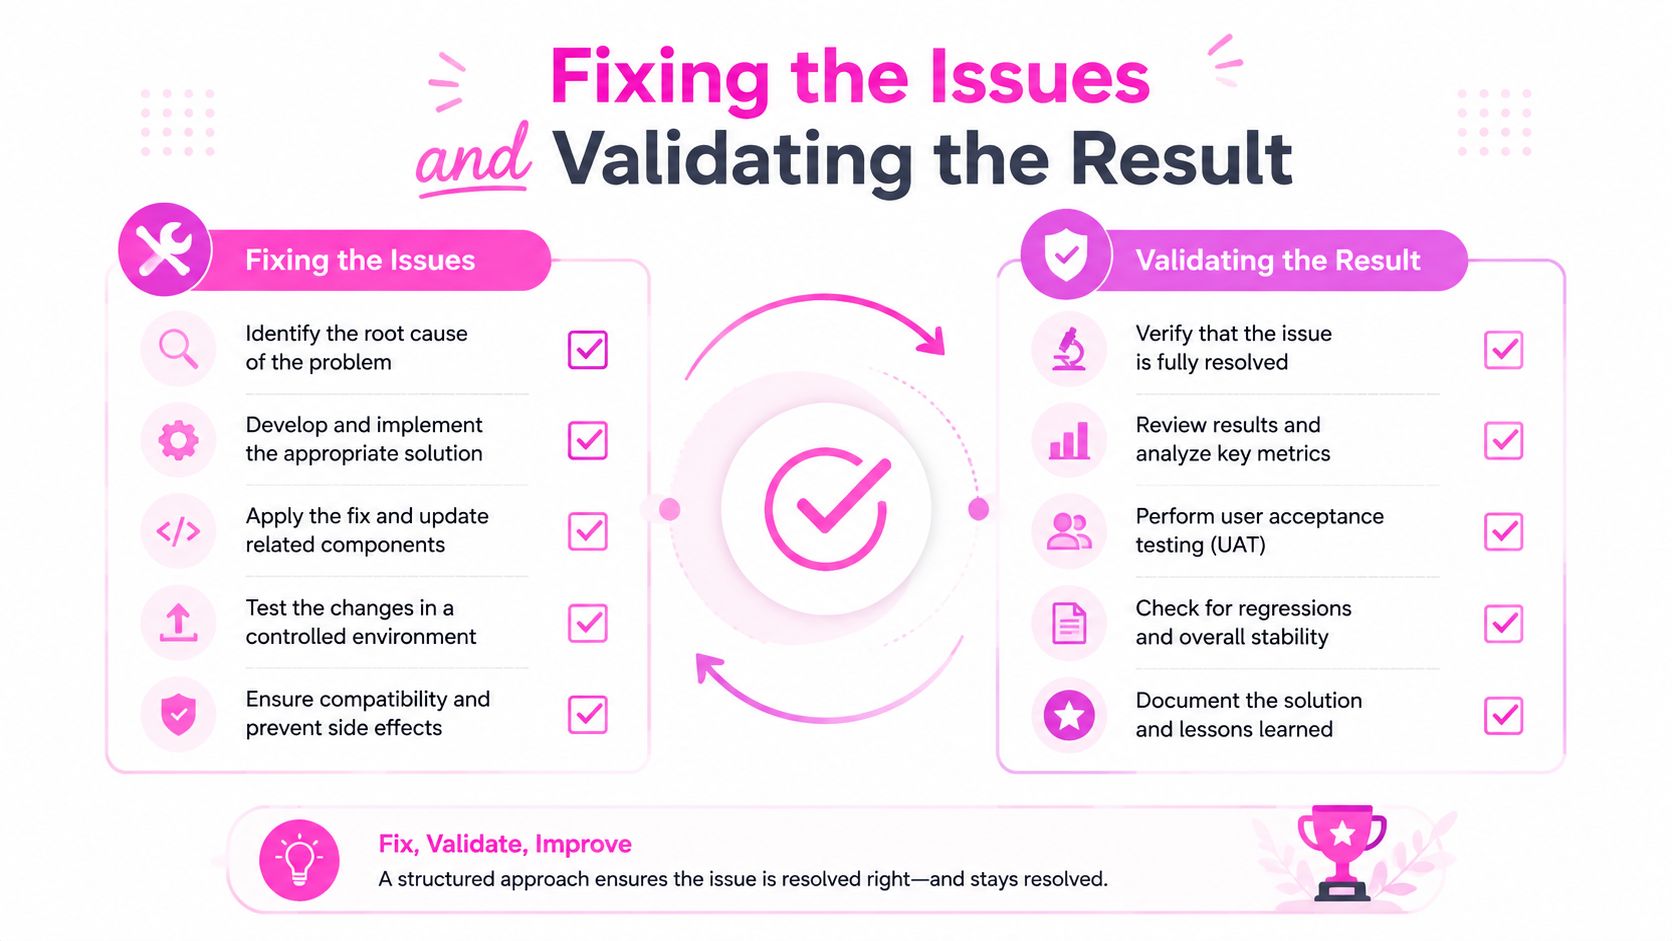
Behebung der Probleme und Validierung des Ergebnisses
Ich behebe zuerst die URLs mit echtem Wert, also solche, die bereits Links erhalten haben oder eine starke Suchnachfrage aufwiesen, bevor sich die Direktive geändert hat. Dann spiele ich den Fix über das Template oder die Header-Ebene ein, statt einzelne Seiten nacheinander zu bearbeiten, da einmalige Fixes beim nächsten CMS-Update verloren gehen. Die saubersten Implementierungen sind diejenigen, bei denen der Grund für die Direktive direkt neben der Regel dokumentiert ist.
Wie ich die Korrektur überprüfe
Ich beobachte die URL in den SERP-Verlaufs- und Mapping-Ansichten und bestätige dann, dass sich die gerenderte Quelle oder die Response-Header geändert haben. Wenn die Seite zuvor unterdrückt wurde, erwarte ich, dass sich der Indexierungsstatus erst ändert, nachdem der Crawler die URL erneut verarbeitet hat. Deshalb vertraue ich nicht allein auf das Speichern einer Vorlage.
Die Validierungsschleife ist einfach:
- Bestätigen, dass die Direktive verschwunden oder korrigiert ist im Quellcode oder in den Headern.
- Die URL erneut crawlen und überprüfen, ob sich der SERP-Status ändert.
- Achte auf Kollisionen in der Nähe, da Vorlagenkorrekturen auf Geschwister-URLs übergreifen können, wenn die Regel zu breit ist.
- Hinterlasse eine Notiz in der Vorlage, damit der nächste Entwickler weiß, warum die Direktive existiert.
Praktische Regel: Wenn eine Seite kein Meta-Robots-Tag benötigt, lass es weg. Wenn sie eines benötigt, dokumentiere den Grund dort, wo die Vorlage lebt.
Der eigentliche Sinn ist es, unsichtbare SEO-Schäden zu stoppen, bevor sie sich verstärken. Das ist der Wert eines straffen Robots-Workflows, und deshalb validiere ich lieber mit der Seite selbst, anstatt mich auf Annahmen, Screenshots oder das Gedächtnis von jemandem zu verlassen.
Wenn du eine sauberere Methode suchst, um Robots-Direktiven-Fehler zu erkennen, bevor sie den Traffic beeinträchtigen, nutze SemDash um die Sichtbarkeit auf URL-Ebene abzubilden, den SERP-Verlauf zu verfolgen und Indexierungsänderungen zu erkennen, solange sie noch behoben werden können. Es ist der schnellste Weg, den ich kenne, um eine Crawl-Anomalie mit der genauen Seite zu verbinden, die sie verursacht hat, und dann den Erfolg der Korrektur nachzuweisen.