Die meisten Ratschläge zur Keyword-Kannibalisierung beginnen an der falschen Stelle. Wenn ich sehe zwei URLs ranken für ein Keyword, nenne ich das noch kein Problem, ich nenne es einen Hinweis. Das Problem ist normalerweise Instabilität der Suchanfragen-Besitzerschaft, bei der Google ständig zwischen Seiten, Oberflächen oder Absichten wechselt, anstatt sich auf eine klar bevorzugte URL festzulegen.
Diese Unterscheidung ist wichtig, da viele Teams Seiten zu früh zusammenführen und die benötigte Abdeckung beschädigen. Eine Suchanfrage kann in einer Tabelle doppelt erscheinen und dennoch gesund sein, wenn eine Seite die Hauptabsicht abdeckt, während eine andere einen spezifischeren Bedarf bedient. Das Audit, dem ich vertraue, beginnt mit einer schwierigeren Frage: welche URL gewinnt diese Abfrage im Laufe der Zeit, und ist der Gewinner stabil?
Inhaltsverzeichnis
- Warum die meisten Kannibalisierungsdiagnosen falsch sind
- Erstellen deiner Suchkonsole-Abfrage-zu-Seite-Zuordnung
- Überlagerung von Website-Suchen, Crawls und Ranking-Historie-Prüfungen
- Vier Tests, die echte Kannibalisierung von Rauschen unterscheiden
- Wie eine echte Audit tatsächlich aussieht
- Bewertung und Priorisierung von Suchanfragen, die eine Korrektur wert sind
- Audit-Checkliste und was nach der Identifizierung kommt
Warum die meisten Kannibalisierungsdiagnosen falsch sind
Die Abkürzungsdiagnose, „zwei URLs ranken für ein Keyword“erfasst zu viel Rauschen. Ich habe gesehen, wie Teams Seiten zusammengelegt haben, die unterschiedliche Absichten bedienten, und dann Monate damit verbrachten, Long-Tail-Traffic wieder aufzubauen, den sie hätten behalten können. Die sicherere Definition ist enger gefasst: Eine Abfrage wird kannibalisiert, wenn die Inhaberschaft sich in den letzten Wochen verschiebt zwischen den Seiten, die CTR hinter dem zurückbleibt, was der kombinierte Impression Share vermuten lässt, und keine einzelne Seite eine stabile Position hält.
Deshalb ist ein einzelner Schnappschuss ein schwacher Beweis. Die Search Console kann Überschneidungen zeigen, ohne Schaden nachzuweisen, und breite Überschneidungen sind manchmal normaler interner Wettbewerb und kein strukturelles Problem, insbesondere wenn eine URL eindeutig dominiert. Der praktische Maßstab, den ich verwende, ist, ob die Abfrage konkurrierende URLs mit ähnlichen Titeln oder H1szeigt, überlappende Impressionen und ein Muster von URL-Wechseln, nicht nur nebeneinander bestehende Ergebnisse.
Was ich suche, bevor ich es Kannibalisierung nenne
Ein sauberes Audit trennt drei Situationen, die oft vermischt werden:
- Intent-Segmentierung, bei der sich zwei Seiten ein Thema teilen, aber unterschiedliche Bedürfnisse erfüllen.
- SERP-Verdrängung, bei der KI-Funktionen oder andere Ergebnisarten organische URLs verschieben.
- Echte Kannibalisierung, bei der sich Google nicht für eine Seite entscheiden kann, weil die Website immer wieder gemischte Signale sendet.
Diese Darstellung stimmt mit modernen Search Console-Workflows überein, die Abfragen und Seiten exportieren, die Anzahl eindeutiger URLs pro Abfrage zählen und den wechselnden URL-Besitz im Laufe der Zeit überprüfen, anstatt sich auf eine Datenansicht zu verlassen. Sie entspricht auch dem Rat, stabile Überlappungen über Wochen hinweg zu vergleichen und nicht nur einen einzelnen Ranking-Schnappschuss, da Volatilität das zugrunde liegende Problem aufdeckt. Ein schneller site:yourdomain.com keyword Suche kann helfen, ist aber nur ein erster Schritt, kein Beweis, da sie Relevanz- und Indexierungssignale zeigt, keine vollständigen Impressionen oder Klickdaten. Wie in der früheren Anleitung von Search Engine Journal erwähnt, ist die stärkste Heuristik immer noch eine Suchanfrage mit 2 oder mehr konkurrierenden URLs, ähnlichen Titeln und überlappenden Impressionen.
Erstellen deiner Suchkonsole-Abfrage-zu-Seite-Zuordnung
Der sauberste Weg, den ich gefunden habe, um Keyword-Kannibalisierung zu identifizieren, ist, mit Search Console Performance-Datenzu beginnen, nicht mit einem Crawl-Export oder einem Rank-Tracker. Ich ziehe zuerst die letzten 16 Wochen an Abfragen und Seiten, da dieses Zeitfenster lang genug ist, um wechselndes Verhalten zu erfassen, ohne veraltete Daten einzubeziehen, die das Muster verzerren. Wenn eine Website groß ist, setze ich einen Arbeitsfilter bei 50+ Impressionen , damit die Tabelle sich auf Abfragen konzentriert, die Traffic bewegen können.
Der Zuordnungs-Workflow, den ich verwende
- Exportiere Abfragen und Seiten separat. Ich lasse die Rohdateien unberührt und normalisiere URLs, bevor ich etwas aggregiere. Das ist wichtig, denn Unterordnergruppierungen, Parameter-Varianten und Inkonsistenzen bei nachgestellten Schrägstrichen können eine Seite wie mehrere aussehen lassen.
- Erstelle eine Query-zu-Page-Map. Liste in einer Tabelle oder Looker Studio jede Suchanfrage und jede Seite auf, die Impressionen dafür erhalten hat, und füge dann Klicks, CTR und durchschnittliche Position hinzu. Die durchschnittliche Position allein kann irreführend sein, da eine Seite, die in vielen gemischten SERPs erscheint, eine ordentliche Durchschnittsposition aufweisen kann, während sie dennoch die Inhaberschaft verliert.
- Zähle eindeutige URLs pro Suchanfrage. Ich markiere Suchanfragen mit 2 oder mehr URLs die Impressionen erhalten, und ignoriere dann Fälle, in denen die sekundäre URL unter 5% der Gesamtklicksbeiträgt. Das verhindert, dass gutartige Überlappungen die Überprüfungswarteschlange verunreinigen.
- Sortiere nach Klick-Share-Konzentration. Wenn keine einzelne URL mehr als 70% der Klicksbesitzt, betrachte ich die Suchanfrage als ernsthaften Kandidaten.
Praktische Regel: Wenn sich die Query-zu-Page-Map wöchentlich ändert, ist mir das wichtiger, als die Rohanzahl der Seiten.
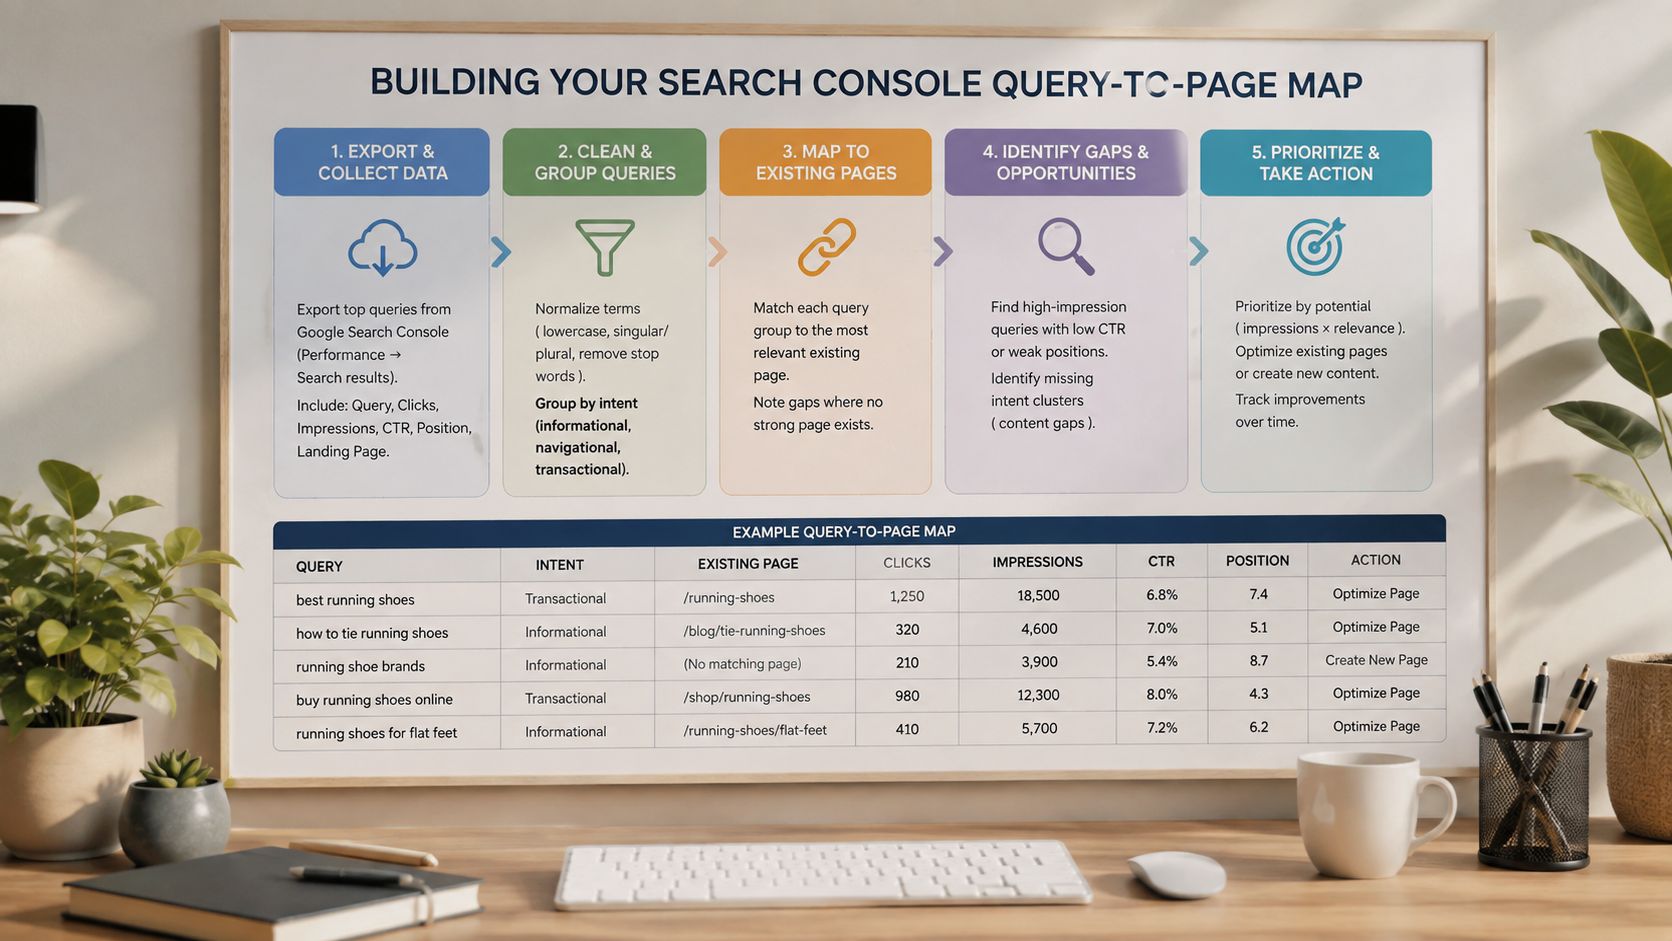
Der Datumsbereich ist wichtig, da das Wechselverhalten zeitlich bedingt ist. Ich habe schon Anfragen gesehen, die in einer 28-Tage-Momentaufnahme sauber und in einem 16-Wochen-Export unübersichtlich aussahen. Das breitere Fenster hilft mir auch, überlappende Seiten von echten Formatunterschieden zu trennen, wie z. B. Bild-, Video- oder Produktergebnis-URLs, die neben Standardseiten erscheinen können.
Ein gutes Audit-Sheet sollte auch ein einfaches Notizfeld für jede Anfrage enthalten, damit ich festhalten kann, ob die Überlappung wie Indexierungsrauschen, Inhaltsduplizierung oder echte Instabilität der Eigentümerschaft aussieht. Dieses Protokoll wird zur Beweiskette, wenn es an der Zeit ist zu entscheiden, ob die Seiten zusammengeführt, kanonisiert oder unverändert gelassen werden sollen.
Überlagerung von Website-Suchen, Crawls und Ranking-Historie-Prüfungen
Eine GSC-Auswahlliste ist nur der erste Schritt. Ich validiere jeden Kandidaten mit drei Ebenen, damit ich nicht dasselbe Signal in verschiedenen Tools doppelt zähle. Die Reihenfolge ist wichtig, denn eine Seite kann in der Search Console wettbewerbsfähig erscheinen und sich dann als harmlose Überschneidung herausstellen, sobald ich Absicht, Indexierung und Ranking-Historie zusammen prüfe.
Wie ich eine Kandidaten-Query validiere
Zuerst verwende ich den site: Operator für die exakte Abfrage und prüfe, welche URLs Google bereits damit verknüpft. Diese schnelle Suche gibt mir einen Eindruck vom Snippet-Typ, den Sitelinks und ob eine KI-Übersicht oder eine andere Ergebnisoberfläche organische Klicks verdrängt, anstatt einen klassischen Seiten-gegen-Seiten-Konflikt auszulösen. Es ist ein Screening-Schritt, kein Urteil.
Zweitens, ich durchsuche die Kandidaten-URLs. Ich suche nach dünnen Überschneidungen, gemeinsam genutzten Vorlagentexten, hreflang-Duplizierung und internen Ankertexten, die Google zur schwächeren Seite lenken. Wenn der Crawl die gleichen Absichtshinweise auf beiden URLs zeigt, betrachte ich das als Bestätigung. Wenn die Seiten klar abweichen, markiere ich die Überschneidung als beabsichtigt und mache weiter.
Drittens, ich überprüfe die Ranking-Historie über ein rollierendes Fenster. Ich verwende Tools wie AccuRanker, Semrush oder tägliche Search Console-Abfragen und habe festgestellt, dass das Muster des URL-Wechsels viel wichtiger ist als ein einzelner Positionsrückgang. Wenn sich die Top-URL für dieselbe Abfrage ständig ändert, ist das ein starkes Zeichen dafür, dass die Website keine klare Inhaberschaft etabliert hat.
Für Teams, die eine breitere Tracking-Schicht wünschen, ist der Leitfaden zur KI-gestützten Ranking-Verfolgung nützlich, da er die Rangbewegung um URL-spezifische Verschiebungen und nicht nur um die Keyword-Position rahmt. Das passt besser zur Kannibalisierungsarbeit als Dashboards, die alles zu einer einzigen durchschnittlichen Position abflachen.
| Schicht | Tool oder Quelle | Was es bestätigt | Schwellenwert |
|---|---|---|---|
| Suchsichtbarkeit | Google Search Console | Mehrere URLs erhalten Impressionen für dieselbe Suchanfrage | 2 oder mehr konkurrierenden URLs |
| Index- und SERP-Prüfung | site: Suche und Live-SERP-Überprüfung |
Welche URLs Google bereits mit dem Begriff verknüpft, plus Snippet- und KI-Oberflächenkontext | Mehr als eine relevante URL wird angezeigt |
| Verlaufsprüfung | Rank-Tracker oder tägliche GSC-Abrufe | Ob die Zuordnung stabil ist oder wechselt | Wiederholter URL-Wechsel im Laufe der Zeit |
Ein Kandidat kommt nur dann weiter, wenn mindestens zwei der drei Ebenen unabhängig voneinander aktiven Wettbewerb zeigen. Diese Regel bewahrt mich davor, auf normale Volatilität überzu reagieren. Sie liefert mir außerdem eine nachvollziehbare Notiz für die Audit-Datei, was wichtig ist, wenn ein Kunde später fragt, warum eine Seite unverändert blieb und eine andere zusammengelegt wurde.
Für eine Crawling-basierte Diagnose behalte ich zudem die Indexsteuerung im Blick. Die internen Richtlinien zur Meta-Robots-Tag-Handhabung sind relevant, wenn die schwächere Seite für Nutzer zugänglich bleiben muss, aber nicht in der Suche konkurrieren soll.
Vier Tests, die echte Kannibalisierung von Rauschen unterscheiden
Der schnellste Weg, schlechte Fixes zu vermeiden, ist, die Überschneidung anhand des Verhaltens zu testen, nicht nur anhand von Keywords. Ich verwende vier Tests, da jeder eine andere Fehlerart erkennt. Eine Seite kann einen Test bestehen und trotzdem ein schlechter Kandidat für eine Konsolidierung sein, wenn ein anderer Test eine klare Trennung der Absicht zeigt.
Das Vier-Test-Framework
Test 1, Flip-Flop-Häufigkeit. Ich ordne die Ranking-Bewegungen über 90 Tage zu und markiere nur Abfragen, bei denen zwei URLs mindestens dreimalinnerhalb der Top 10 wechseln. Dieses Muster ist schwer als gewöhnliches Ranking-Rauschen abzutun.
Test 2, SERP-Feature-Korrelation. Ich vergleiche die Überschneidung mit der Live-SERP. Wenn der Seitenverlust nur auftritt, nachdem KI-Übersichten oder PAA-Boxen organische Listings nach unten verschieben, betrachte ich dies als Verdrängung, nicht als Kannibalisierung.
Test 3, Absichtsgradient. Ich vergleiche Titel, H1s und die Entitätsabdeckung des ersten Absatzes. Wenn eine Seite informativ und die andere transaktional ist, oder eine für Anfänger und die andere für fortgeschrittene Benutzer gedacht ist, kann die Überschneidung eine gesunde Segmentierung sein.
Test 4, CTR-Verteilung. Wenn Impressionen auf zwei URLs aufgeteilt werden, aber die Klicks hinter dem zurückbleiben, was eine einzelne stärkere Seite erzielen sollte, ist das verschwendeter Inventar. Das Problem ist nicht nur, dass zwei Seiten existieren, sondern dass keine von beiden die verfügbare Aufmerksamkeit effizient nutzt.
| Test | Was es misst | Echtes Kannibalisierungssignal | Rauschsignal |
|---|---|---|---|
| Flip-Flop-Frequenz | URL-Besitz im Zeitverlauf | Zwei URLs wechseln sich wiederholt ab | Eine URL bleibt dominant |
| SERP-Feature-Korrelation | Organische Verdrängung | Verlust fällt mit Feature-Überfüllung zusammen | Überlappung spiegelt nur SERP-Volatilität wider |
| Intent-Gradient | Unterschiedliche Nutzerbedürfnisse | Gleiche Absicht, gleiche Zielgruppe, gleiche Seitenfunktion | Klare Aufteilung zwischen informativ und transaktional |
| CTR-Verteilung | Klickeffizienz | Aufgeteilte Impressionen mit schwachen kombinierten Klicks | Eine URL besitzt Klicks trotz Überlappung |
Ein funktionierendes Beispiel hilft. Für „die besten Laufschuhe“ Ich habe gesehen, dass sowohl eine Liste als auch eine Bewertung ranken, aber die Suchanfrage ändert sich je nach Budget und Anwendungsfall. Das ist normalerweise Segmentierung, da jede Seite eine andere Sub-Intention bedient. Ich würde beide beibehalten und ihre Zielgruppen verfeinern.
Ein besseres Beispiel für Kannibalisierung ist „iPhone zurücksetzen“. Wenn Apple Support und ein Blog abwechselnd auf den Positionen 4 und 6 erscheinen und die kombinierte CTR hinter dem zurückbleibt, was ein einzelnes stabiles Ergebnis erfassen sollte, signalisiert die Website Verwirrung. Das ist kein Problem des Content-Ökosystems, sondern ein Problem der Suchanfragen-Hoheit.
Eine Seite muss nicht identisch mit einer anderen Seite sein, um sie zu kannibalisieren. Sie muss nur immer wieder die gleiche Klickmöglichkeit stehlen, ohne sie sauber zu gewinnen.
Wie eine echte Audit tatsächlich aussieht
Auf einer mittelgroßen E-Commerce-Website mit ungefähr 2.400 Produkt- und Kategorie-URLsbeginne ich mit dem Abrufen von 16 Monaten der Search Console-Daten, damit saisonale Nachfrage das Muster nicht verbirgt. Diese breitere Sicht ist bei E-Commerce-Objekten wichtig, da eine Anfrage während eines Kaufzyklus stabil und in einem anderen instabil aussehen kann. Ich filtere nach Anfragen, die durchschnittlich 50+ Impressionen pro Monat haben und behalte nur diejenigen mit 2 oder mehr Ranglisten-URLs.
Dann schwenke ich nach Abfrage und beobachte, welche URLs im Laufe der Zeit erscheinen. Für eine Abfrage wie „kabellose Ohrhörer“ habe ich jedes URL-Paar nach Überlappungsdauer getaggt und eine Kategorieseite und einen Einkaufsführer gefunden, die beide für sieben MonateTop-5-Positionen hielten und wöchentlich wechselten. Das war ein echter Kannibalisierungsfall, weil der Besitz ständig wechselte und keine Seite eine klare Rolle einnahm. Ich habe einen Screaming Frog Crawl hinzugefügt, um als nächstes interne Links zu inspizieren. Die schwächere Seite hatte mehr kontextbezogene Anker als sie hätte haben sollen, was einen Teil der Verwirrung erklärte. Die stärkere Seite wurde durch ein Navigationsmuster verwässert, das im CMS ordentlich aussah, aber in den Crawl-Daten unordentlich war.
Ich habe einen Screaming Frog Crawl hinzugefügt, um als nächstes interne Links zu inspizieren. Die schwächere Seite hatte mehr kontextbezogene Anker als sie hätte haben sollen, was einen Teil der Verwirrung erklärte. Die stärkere Seite wurde durch ein Navigationsmuster verwässert, das im CMS ordentlich aussah, aber in den Crawl-Daten unordentlich war.
Derselbe Datensatz hat mir eine falsche Fährte geliefert bei „kabellose Kopfhörer zum Laufen.“ Der rohe Export sah fast identisch aus, aber die Seiten teilten sich sauber nach Suchintention auf: ein Übersichtsartikel und eine Produktseite. Ich habe den Umleitungsplan dort verworfen, da eine Zusammenlegung die Long-Tail-Abdeckung verschlechtert und einen nützlichen Weg für Käufer mit spezifischerem Bedarf entfernt hätte.
Für Teams, die das im großen Stil machen, ist der SEO-Audit für Agenturen durchführen Framework ein solider Begleiter, da es die Überprüfung zwingt, von der Entdeckung zur Priorisierung überzugehen, ohne die Beweiskette zu überspringen.
Die von mir verwendete Pivot-Logik
- Zusammenlassen: gleiche Suchanfrage, gleiche Intent, instabile Inhaberschaft.
- Trenne: gleicher Suchbegriff, unterschiedliche Zielgruppe oder Anwendungsfall.
- Aktion verzögern: Überschneidung ist vorhanden, aber eine URL holt sich die Klicks konstant.
Genau diesen letzten Bereich ignorieren viele Teams. Eine Seite, die in einer Tabelle unordentlich aussieht, kann funktional völlig in Ordnung sein, wenn die Search Console eine dominante URL und keinen nennenswerten Eigentümerwechsel anzeigt. Ich habe gelernt, solche Fälle nicht einfach zu „reparieren“, nur weil der Export unaufgeräumt aussieht.
Bewertung und Priorisierung von Suchanfragen, die eine Korrektur wert sind
Sobald die Kandidatenliste bereinigt ist, bewerte ich jede Suchanfrage, damit ich keine Zeit mit Überschneidungen von geringem Wert verschwende. Mein Modell verwendet fünf Achsen, die jeweils mit 0 bis 3bewertet werden. Das Ziel ist keine mathematische Perfektion, sondern die Trennung von Suchanfragen, die Maßnahmen rechtfertigen, von denen, die auf der Beobachtungsliste bleiben sollten.
Das von mir verwendete Bewertungsmodell
- Volumengrenze. Höhere monatliche Impressionen erhalten eine höhere Punktzahl, da das Potenzial größer ist.
- Umsatz- oder Conversion-Wert. Ein kommerzieller Suchanfrage-Cluster ist wichtiger als ein rein informativer Eitelkeitsbegriff.
- Positionsvolatilität. Mehr Ranking-Wechsel pro Monat bedeuten mehr Instabilität.
- CTR-Defizit. Eine größere Lücke im Vergleich zur prognostizierten Klickkurve für den ersten Platz bedeutet mehr ungenutzte Nachfrage.
- Einfachheit der Behebung. Seiten mit ähnlichem Inhalt und klarer Link-Equity sind leichter sauber zu beheben.
Ich gruppiere alles darunter 7/15 als nur zu überwachen. Meiner Erfahrung nach scheitern diese Anfragen normalerweise am Kostentest, die Wiederherstellungsgrenze ist zu niedrig oder die Absicht ist zu unklar, um sie sicher zu bereinigen. Anfragen, die höher bewertet werden, werden in „sofort beheben“ oder „für den nächsten Sprint planen“ verschoben, je nachdem, wie direkt die Seiten gelöst werden können.
Wenn Sie vor dem Bewerten clustern, hilft der Keyword-Clustering-Workflow dabei, Seitenthemen offensichtlicher zu machen, bevor Sie entscheiden, welche URL sie besitzen soll.
| Kriterium | Gewichtung (0-3) | Was bewertet werden soll | Schwellenwert für Maßnahmen |
|---|---|---|---|
| Durchschnittliche monatliche Impressionen | 0-3 | Nachfrage und Potenzial | Stärkeres Volumen erhöht die Priorität |
| Umsatz oder Konversionswert | 0-3 | Geschäftsauswirkung | Kommerzieller Wert drängt in Richtung „sofort beheben“ |
| Positionsvolatilität | 0-3 | Häufigkeit von Wechseln | Häufige Wechsel erfordern Aufmerksamkeit |
| CTR-Defizit | 0-3 | Verlust im Vergleich zu erwarteten Klicks | Klares Defizit erhöht die Dringlichkeit |
| Einfachheit der Behebung | 0-3 | Ähnlichkeit und Link-Equity | Sauberere Behebungen erzielen höhere Punktzahlen |
Am früheren Beispiel, „kabellose Ohrhörer“ würde normalerweise gut abschneiden, da sie kommerziellen Wert, sichtbare Volatilität und einen plausiblen Konsolidierungspfad aufweist. „Kabellose Ohrhörer zum Laufen“ würde normalerweise schlechter abschneiden, da die Absichtsaufteilung klarer ist und der geschäftliche Fall für die Zusammenführung schwach ist. Ich würde diese zweite Abfrage lieber überwachen, als eine Zusammenführung zu erzwingen, die die Produktdetektion verwischt.
Leitplanke: Ich genehmige keine Zusammenführung, es sei denn, die Seiten teilen eine klare Absichtsüberschneidung, die stark genug ist, um den Verlust einer URL zu rechtfertigen.
Diese eine Regel hat mehr Traffic gerettet als jede Scoring-Tabelle. Die Versuchung, zu viel zusammenzuführen, ist real, besonders wenn ein Kunde einen schnellen Sieg will, aber die falsche Zusammenführung kann nützliche Abdeckung über den Long Tail hinweg auslöschen.
Audit-Checkliste und was nach der Identifizierung kommt
Ein klarer Identifizierungsworkflow endet mit einer kurzen Checkliste, nicht mit einem Stapel von Exporten. Ich überprüfe die Abfrage in der Search Console, ordne jede URL zu, die Impressionen erhält, prüfe auf wochenweise Wechsel, führe die site: Bildschirm, den Crawl inspizieren und dann die Ranking-Historie bestätigen. Wenn die Anfrage mindestens zwei der drei Validierungsebenen besteht und hoch genug bewertet wird, um relevant zu sein, erhält sie einen Lösungsplan.
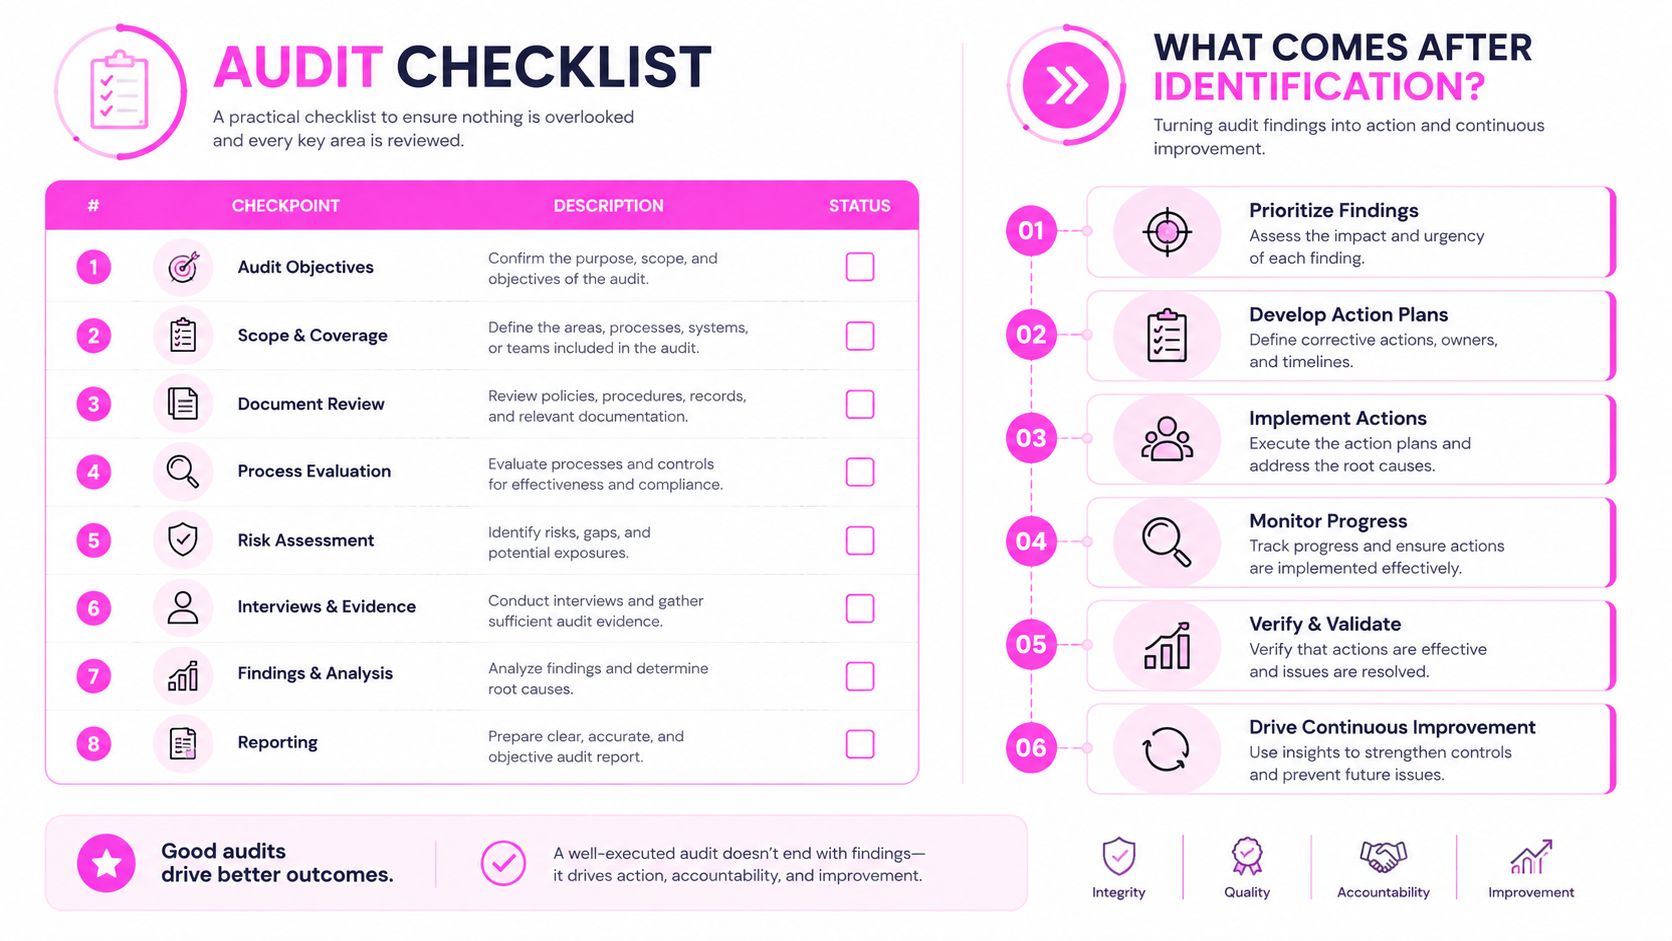
Der Aktionspfad, den ich nach der Identifizierung verwende
- Nahezu doppelte Inhalte kanonisieren wenn die Seiten praktisch identisch sind und beide existieren müssen.
- 301-Weiterleitung wenn eine URL das Thema eindeutig besitzt und die andere das Signal nur schwächt.
- Inhalte zusammenführen nur wenn die Seiten strukturell redundant sind und eine konsolidierte Seite beide bedienen kann.
- Interne Links konsolidieren damit die ausgewählte Seite die stärkste Unterstützung erhält.
- In 30 Tagen erneut prüfen in der Search Console, um zu bestätigen, dass der Besitz der Anfrage stabilisiert ist.
- Reparatur stoppen wenn die Seite stabilen Besitz zeigt und die Überschneidung beabsichtigt ist.
Die größte Falle ist, jedes markierte Paar wie einen Merge-Kandidaten zu behandeln. So zerstören Teams nützliche Intent-Varianten und verlieren Long-Tail-Abdeckung, von der sie nicht wussten, dass sie davon abhängig waren. Ich hatte mehr Erfolg, indem ich zuerst die Anfragen mit instabilem Ownership behoben habe und dann absichtliche Überschneidungen in Ruhe gelassen habe, wenn die Signale zeigen, dass es funktioniert.
Wenn das Muster nach einer 30-tägigen Überprüfung immer noch unübersichtlich ist, schaue ich mir den Intent und die internen Links erneut an, bevor ich den Inhalt selbst anfasse. Query Ownership sagt Ihnen normalerweise, ob die Website umstrukturiert werden muss oder nur klarere Signale benötigt. Sobald das stabil ist, ist das Problem nicht mehr Kannibalisierung, sondern Wartung.
Wenn Sie eine schnellere Möglichkeit suchen, Probleme mit dem Query Ownership über Seiten, Keywords und SERPs hinweg zu erkennen, sehen Sie, wie SemDash überlappende URLs und Themencluster an einem Ort abbildet. Ich verwende solche Tools, wenn ich von der Diagnose zur Priorisierung übergehen möchte, ohne den Faden zwischen Search Console, Ranking-Historie und Intent auf Seitenebene zu verlieren.